100 Cims
Código privado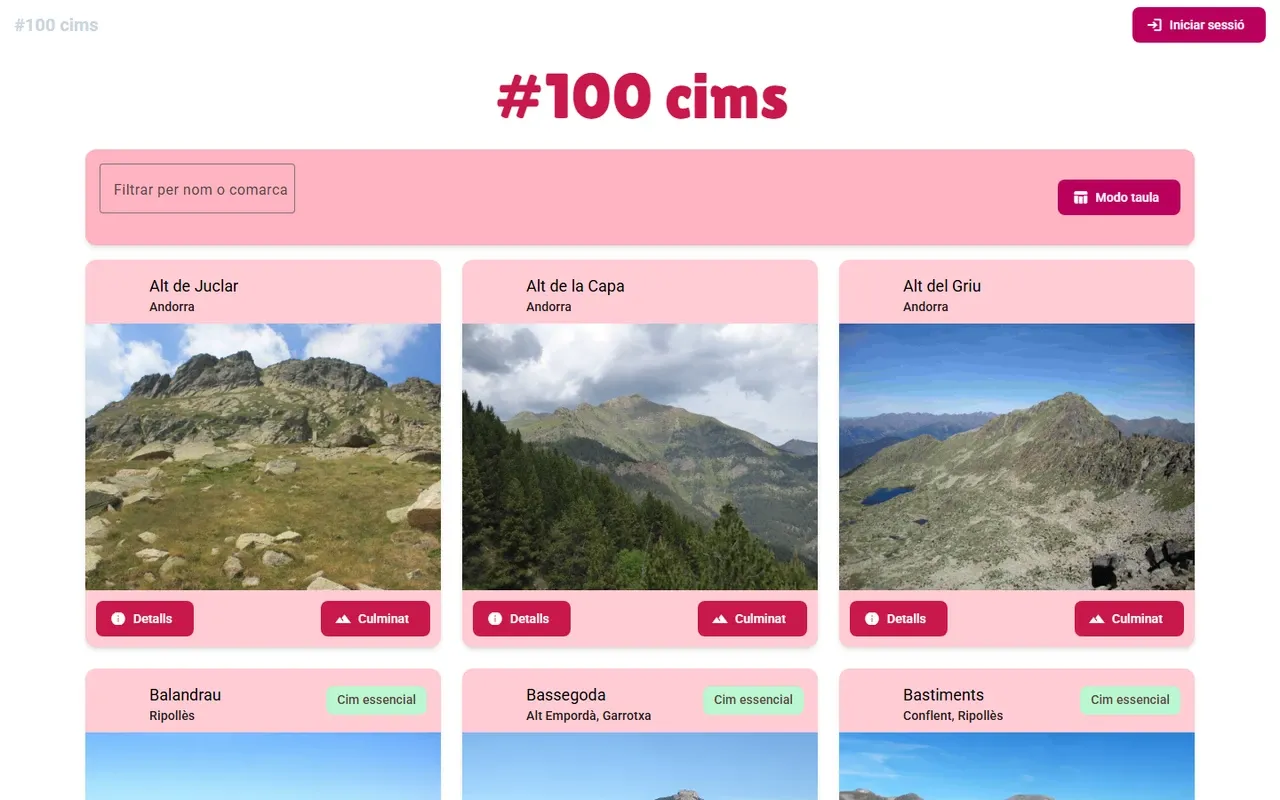
Las 522 cimas del reto, con desplazamiento infinito 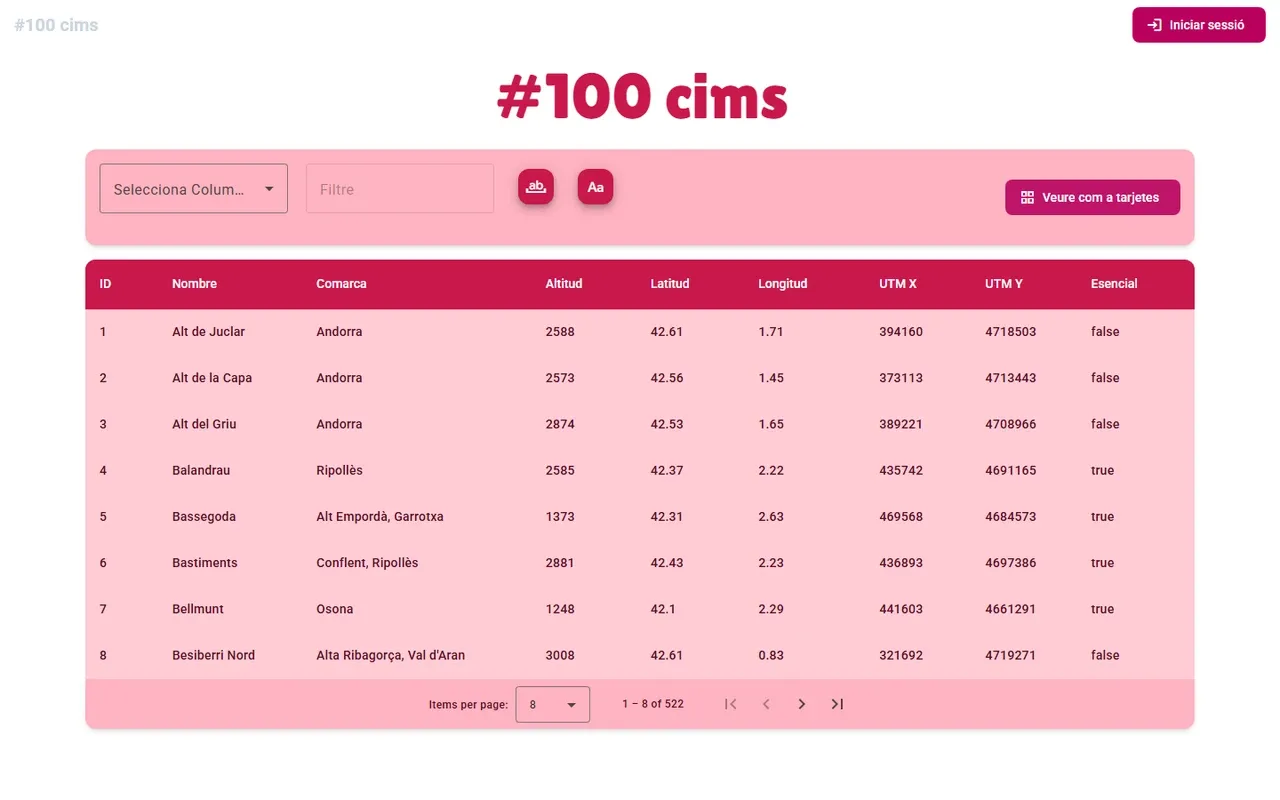
Modo tabla, con filtro y columnas ordenables 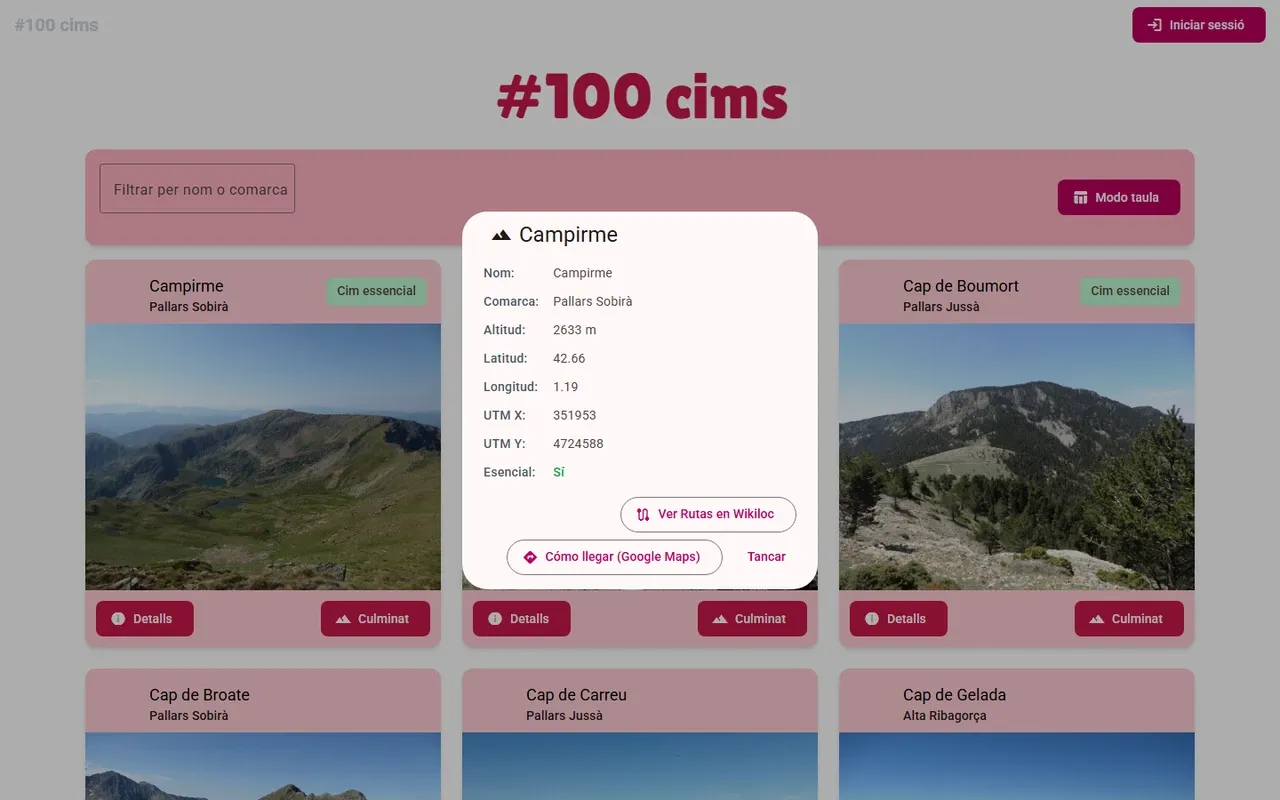
Detalle de una cima, con rutas y cómo llegar
Aplicación sobre el reto de los 100 Cims de la FEEC. Usa Angular para consultar las cimas, una API REST con Spring Boot y PostgreSQL, y scripts en Python para recopilar y preparar los datos y las imágenes.
- API REST con Maven y PostgreSQL 17 en contenedor.
- Proceso en Python que recopila los datos de las cimas y los carga en la base de datos.
- Descarga y optimización de las imágenes a WebP.
- Restauración del conjunto de datos desde CSV.
El problema
El reto 100 Cims de la FEEC son 522 cimas, y la lista oficial vive en documentos pensados para imprimirse: no hay forma de filtrarla, ordenarla ni marcar por dónde vas. Quien lo intenta acaba con una hoja de cálculo a mano que se desactualiza sola. La idea era un catálogo público de las 522 y, detrás de una sesión, el progreso de cada uno.
Mi papel
Todo: la interfaz en Angular, la API en Spring Boot, el esquema de PostgreSQL, la canalización de datos en Python y el empaquetado en Docker.
Decisiones
Los datos los prepara un proceso, no una persona
Siete guiones de Python recogen las cimas, descargan sus imágenes, las optimizan a WebP, las insertan y pueden restaurar el conjunto entero desde el CSV. Teclear 522 filas a mano se hace una vez; cuando la FEEC corrige una altitud o cambia una foto hay que volver a empezar, y entonces el que se cansa reescribe sólo lo que recuerda. Con el proceso, rehacerlo es volver a lanzarlo.
La carga exige exactamente 522, o falla
La migración de Flyway es idempotente y comprueba el número. Una carga que inserta 500 de 522 y sigue adelante deja la aplicación en pie, con aspecto correcto y con veintidós cimas que no existen para nadie; nadie la mira hasta que alguien busca la suya y no está. Fallar en el arranque es ruidoso, y eso es exactamente lo que se quiere de un dato que se carga una vez.
Las imágenes a R2, verificadas por hash
La sincronización con Cloudflare R2 es idempotente, vuelve a descargar cada objeto, compara su SHA-256 y exige que las claves sean exactamente 522. Un «subido correctamente» que nadie vuelve a leer no dice nada: lo que importa es que lo que está arriba sea byte a byte lo que se subió. En desarrollo las sirve Nginx desde la copia local, así que levantar el proyecto no depende del bucket.
Las pruebas de integración van contra una base de verdad
Testcontainers levanta PostgreSQL 18.4 para las pruebas del backend, y si no hay Docker se saltan en vez de caer a una base local. Una prueba contra una base simulada pasa mientras la migración real falla, que es el modo de fallo que de verdad importa aquí; y una que usa la base del portátil arrastra los datos de ayer. Las imágenes de Docker van fijadas por versión **y** digest, para que la de dentro de un año sea la misma.
Resultado
- Las 522 cimas en un catálogo con filtros, fichas, fotografías y tabla ordenable, que se reconstruye entero desde el CSV con un comando.
- El progreso personal queda detrás de Google OAuth, con CSRF para SPA y cookies de sesión `HttpOnly`, `SameSite=Lax` y `Secure`: el catálogo es público y lo que has subido tú, no.
- Todo el stack arranca con un `docker compose up`: PostgreSQL 18, Flyway, la API en Java 25 y el Angular servido por Nginx, con cada imagen fijada por digest.
Qué cambiaría
Las 522 imágenes en WebP entraron en el repositorio antes de que existiera el bucket, y ahí siguen: el historial de Git carga con ellas y hay que purgarlo con `filter-repo` en cuanto el dominio de medios esté conectado. Un binario que entra en Git no se va solo, y reescribir el historial de un repositorio compartido es caro. Hoy empezaría por el almacenamiento de objetos aunque al principio pareciera desproporcionado para una carpeta de fotos.