Asistente Strava/Garmin
Código privado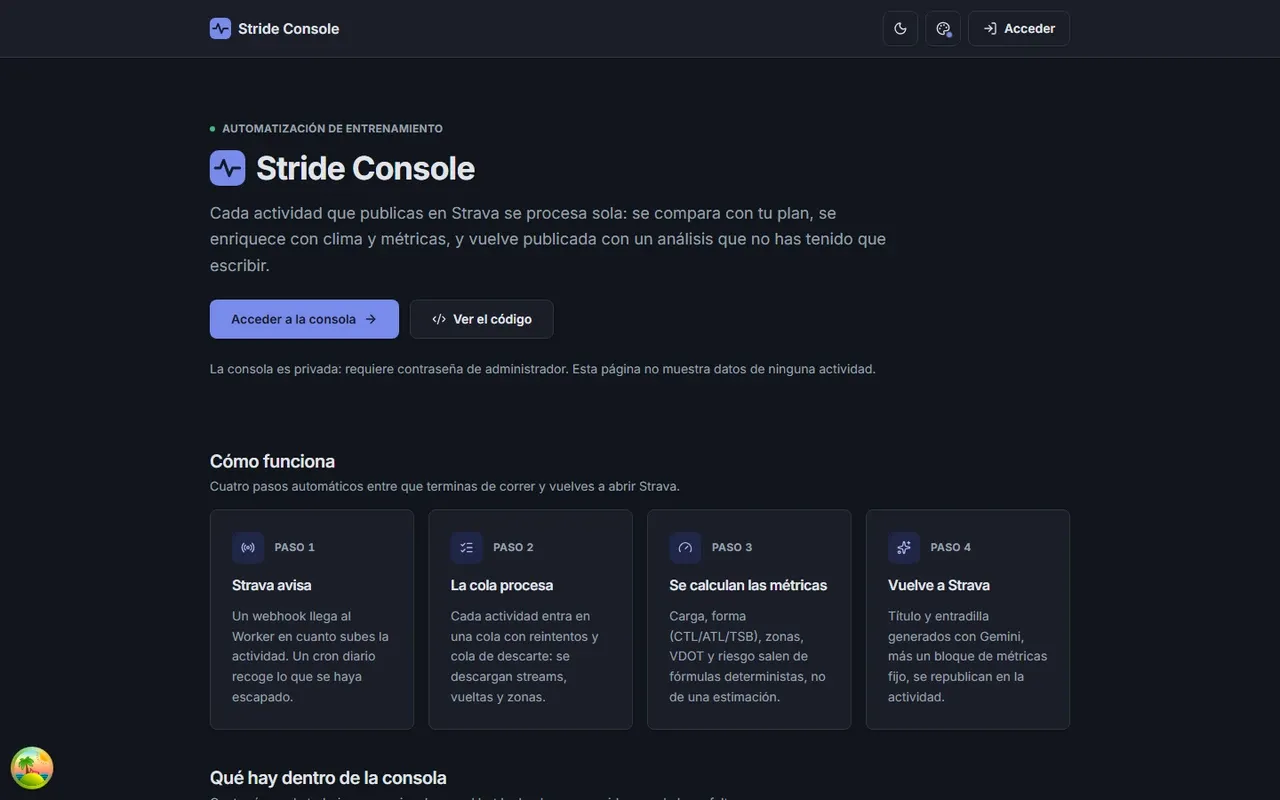
Portada pública, deliberadamente sin datos 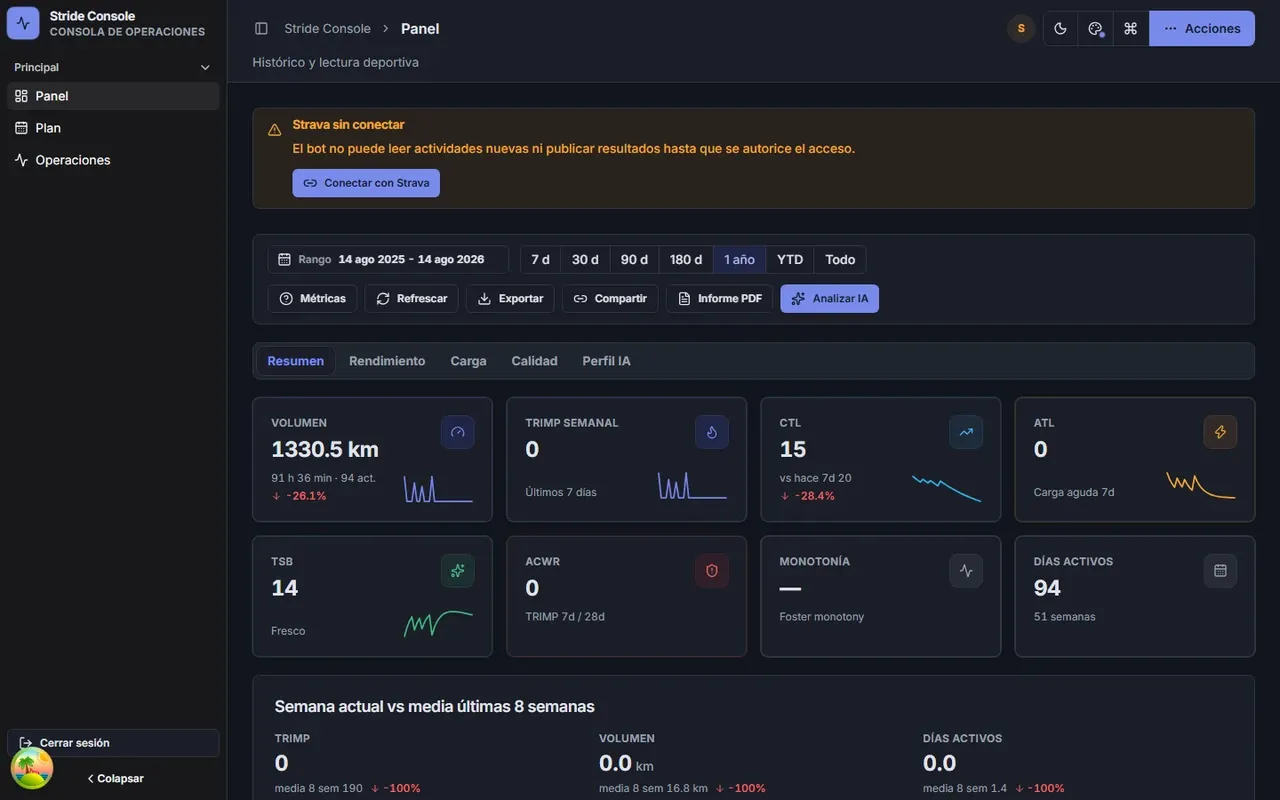
Panel de carga y forma, con la tendencia de cada métrica 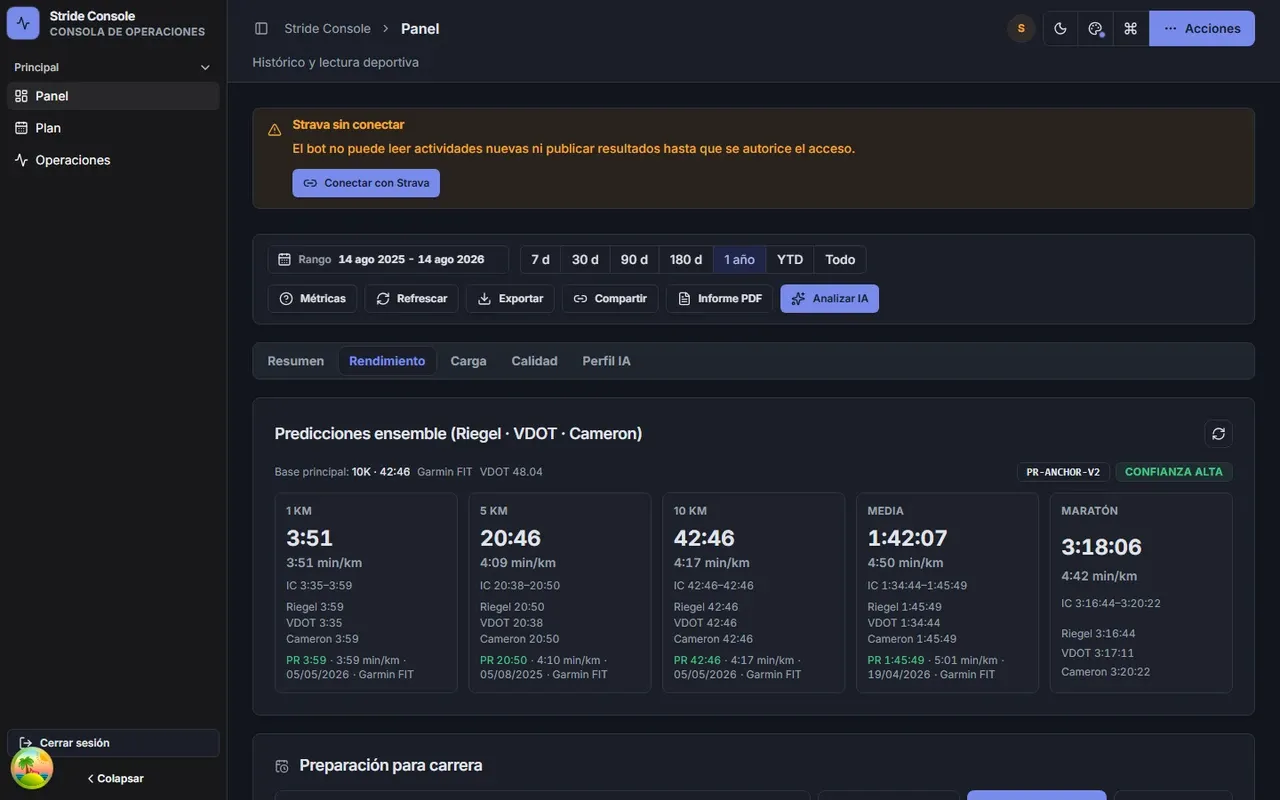
Rendimiento: preparación, predicciones y mejores marcas 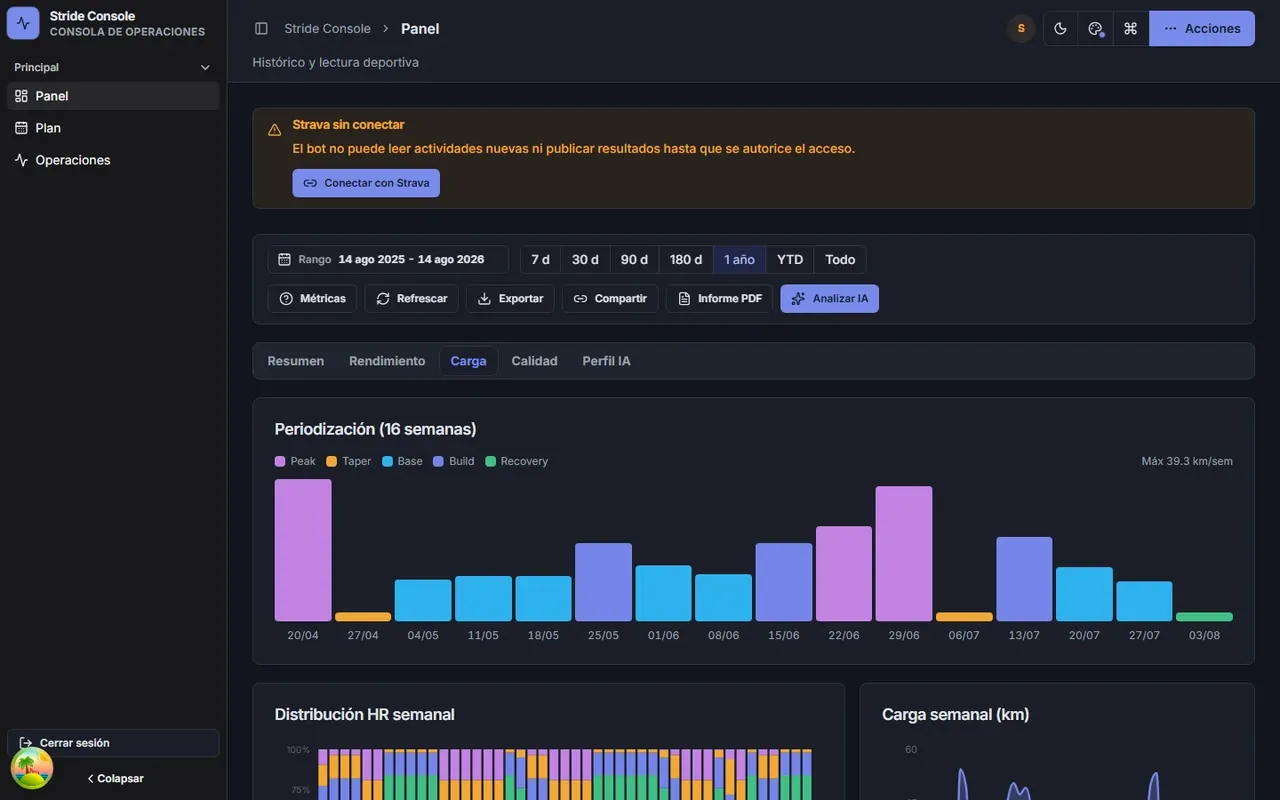
Evolución de la carga aguda y crónica 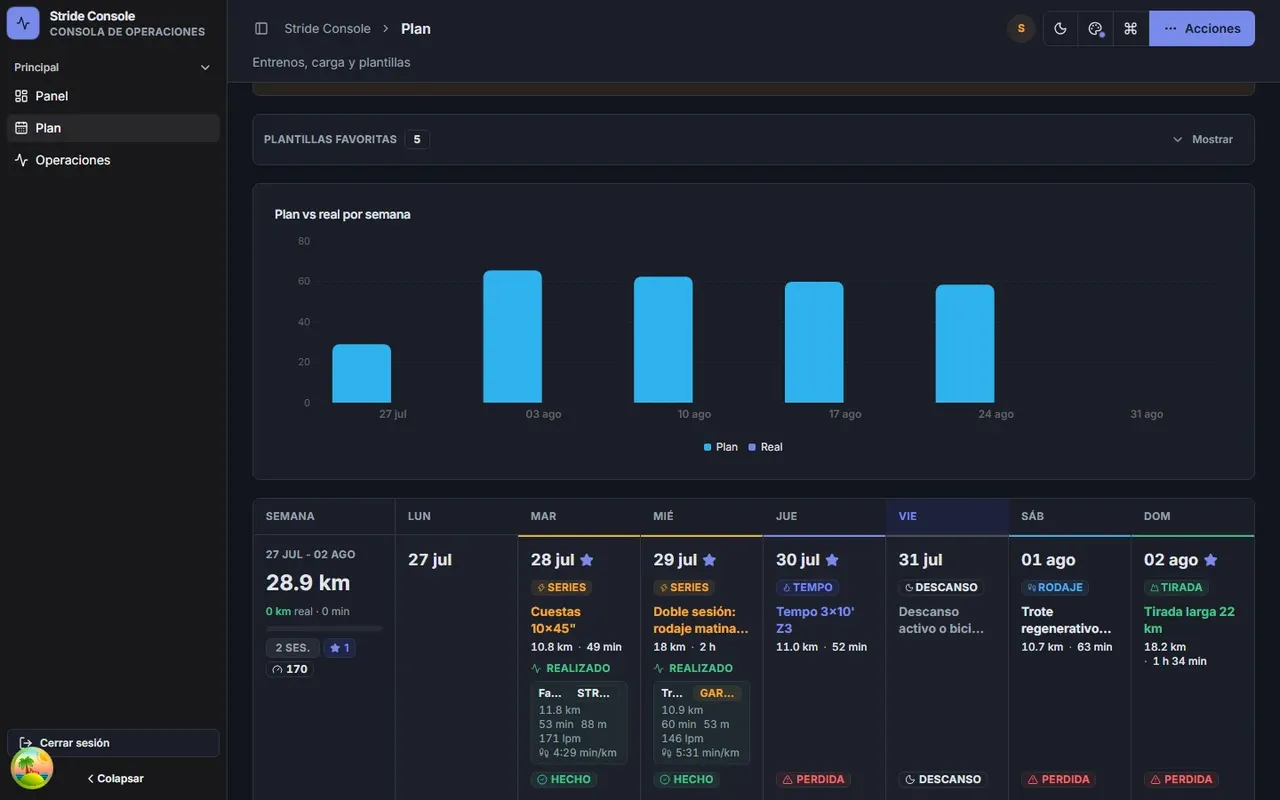
Calendario de entrenamientos: lo planificado frente a lo realizado 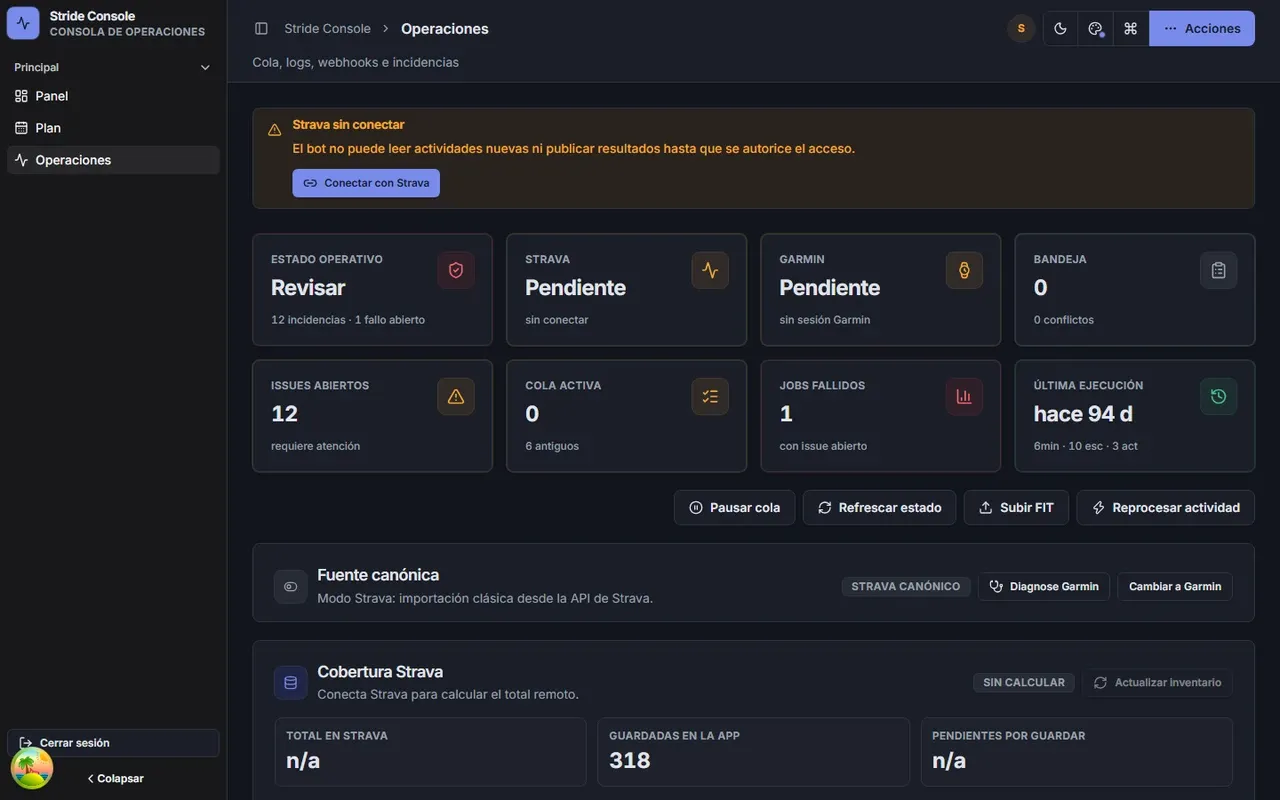
Operaciones: cola, errores, registro y webhooks
Worker de Cloudflare que recibe los webhooks de Strava, compara la actividad principal del día con el plan de entrenamiento y añade el clima y los datos de carrera. Después genera con IA el título y el resumen que publica en Strava.
- Colas con reintentos y cola de mensajes fallidos, más cron horario y purga diaria.
- Tokens de Strava cifrados con AES-GCM antes de guardarse en D1.
- Panel de administración en React servido por el propio Worker.
- Importación de archivos FIT de Garmin y streams de actividad guardados en R2.
El problema
Strava titula cada entrenamiento «Carrera de la tarde» y la descripción se queda vacía, así que el historial de un año no dice nada de cómo fue ninguno de esos días. Los datos para contarlo sí están: el plan de entrenamiento, la meteorología de esa hora y, si la actividad era una carrera, su web oficial. Lo que faltaba era algo que los juntara solo, cada día, sin acordarse.
Mi papel
Todo: el Worker, el esquema de D1, las colas, el panel de administración en React y las herramientas locales que importan los ficheros de Garmin.
Decisiones
El webhook encola y contesta; el trabajo va aparte
Strava da dos segundos para responder a un webhook, y lo que hay que hacer —leer la actividad, cruzarla con el plan, pedir el clima, generar el texto y volver a publicarlo— no cabe. El webhook deja un trabajo en una cola de Cloudflare y responde; la cola lo procesa con reintentos y lo que agota los reintentos cae en una cola muerta en vez de desaparecer. Sin esa segunda cola, un fallo de la API de terceros se traga el día sin dejar rastro.
Al modelo no le llega dónde vives
El punto de inicio de una tirada que sale de casa es el domicilio, y esa coordenada iba entera al prompt de un tercero y se quedaba guardada en claro en la tabla de carreras. Ahora se redondea a dos decimales, que son unos 1,1 km: suficiente para distinguir dos carreras con el mismo nombre en ciudades distintas, que es lo único para lo que estaba ahí, e insuficiente para señalar un portal. Los tokens de Strava, además, van cifrados con AES-GCM en la base.
El modelo escribe la prosa; los números los pone el código
El título y la entradilla los genera un modelo, pero el bloque de métricas es determinista y se calcula aparte. Un modelo que redacta bien también redondea ritmos, inventa un desnivel plausible y nadie lo nota hasta que alguien compara con el reloj. Separarlos deja que cada parte haga lo que sabe, y que un cambio de modelo no mueva ni una cifra.
Garmin se importa desde fuera, no desde el Worker
Garmin Connect no tiene una API abierta como la de Strava: hay que iniciar sesión, pasar el segundo factor y decodificar ficheros FIT. Eso vive en herramientas locales que leen y envían al Worker, en vez de meter credenciales de Garmin y un decodificador binario dentro de algo que corre siempre y de cara a internet. La superficie expuesta se queda en lo que de verdad tiene que estar expuesto.
Resultado
- 197 commits entre abril y septiembre de 2026, 387 ficheros de TypeScript y 36 migraciones de D1: un servicio que lleva meses publicando solo.
- 40 ficheros de pruebas con casi 11 000 líneas, corriendo dentro del propio runtime de Workers y no en un Node simulado.
- Dos fuentes de datos —Strava por webhook y Garmin por fichero FIT— acaban en el mismo historial, con clima y carrera oficial cuando los hay.
Qué cambiaría
La coordenada del domicilio llegó a viajar a un tercero antes de que nadie se preguntara qué se estaba enviando, y se arregló después, leyendo el código con otros ojos. Esa pregunta —qué sale de aquí y a dónde— no se puede dejar para una auditoría: va en el momento de escribir la primera llamada. Y el proyecto creció hasta las 62 000 líneas para algo que usa una persona; la mitad de las funciones del panel las he abierto dos veces.